
O Google lançou em 19/11/2026, em teste (preview), a busca de ferramentas na API do Gemini (Tool Retrieval). O atendente automático deixa de mandar a descrição completa de todas as suas funções em cada pedido e carrega só a que vai usar. Num exemplo ilustrativo da documentação do Google, com números redondos e sem contar saída e cache, a entrada cai 86% com 200 ferramentas. Com 10 ferramentas e uma conversa longa, o pedido fica 37% mais caro. O recurso não tem cobrança à parte.
Atualizado em 19/11/2026. Conferido no anúncio do Google de 19/11/2026 e em três páginas da documentação do Google AI Studio (busca de ferramentas, chamada de funções e tabela de preços), lidas na mesma data.
Neste artigo
- O que o Google lançou
- Quando economiza e quando encarece
- Os três jeitos de entregar as ferramentas
- Cuidados antes de ligar
- Perguntas frequentes
- Fontes
O que o Google lançou
Um atendente com inteligência artificial resolve coisas chamando “ferramentas”: consultar um pedido, emitir a segunda via, abrir um chamado, estornar um valor. Cada ferramenta vai ao modelo com uma ficha dos campos que pede, e até agora todas iam em todo pedido. Segundo o Google, isso gasta tokens, atrasa a resposta e piora a escolha da ferramenta quando a lista cresce.
Com a busca ligada, o modelo continua vendo o nome e a descrição curta de cada ferramenta, mas a ficha completa fica guardada. Quando precisa de uma, a API carrega a ficha e o modelo faz a chamada no mesmo pedido. Para ligar, basta acrescentar a ferramenta “tool_search” e marcar “defer_loading” nas ferramentas que podem esperar. Funciona também com servidores MCP: marcando o servidor, todas as ferramentas dele passam a ser carregadas só quando forem usadas.
Quando economiza e quando encarece
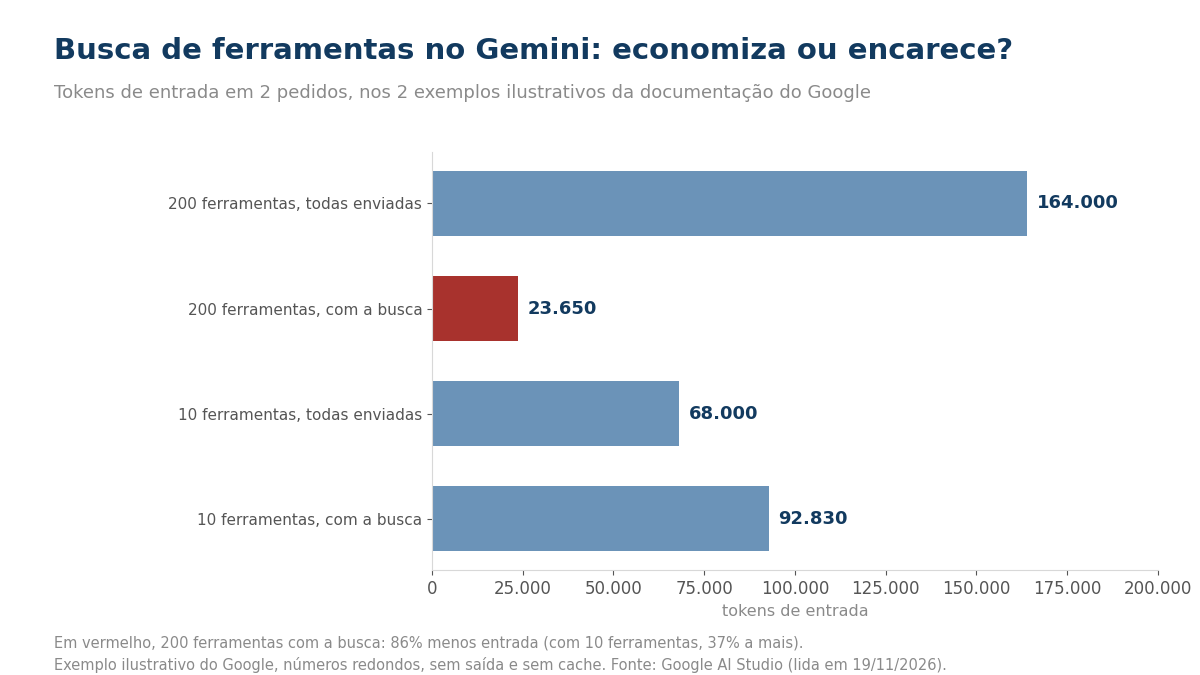
A documentação traz dois exemplos ilustrativos (números redondos, sem saída e sem cache), sempre com 2 pedidos (o que chama a ferramenta e o que devolve o resultado), 2 ferramentas carregadas e fichas de 400 tokens:
- 200 ferramentas, numa conversa de 2.000 tokens: mandando todas, são 164.000 tokens de entrada; com a busca, cerca de 23.650. Queda de 86%.
- 10 ferramentas, numa conversa que já tem 30.000 tokens: mandando todas, 68.000; com a busca, cerca de 92.830. Alta de 37%, porque cada busca é outra chamada ao modelo que reenvia a conversa inteira.
Conta nossa, tratando esses números como entrada no Gemini 4 Hydrogen (US$ 1,50 por milhão de tokens): em mil atendimentos do primeiro tipo, a entrada sai por cerca de US$ 246 sem a busca e US$ 35 com ela. A documentação indica a busca a partir de 20 a 30 ferramentas e pede medir no seu tráfego antes.
Os três jeitos de entregar as ferramentas
| Jeito | Como a ficha chega ao modelo | Código de busca a escrever | Viagem extra por busca | Indicado para |
|---|---|---|---|---|
| Todas enviadas (como era) | Todas, em todo pedido | Nenhum | Nenhuma | Menos de cerca de 20 ferramentas |
| Busca no Google | O Gemini carrega quando precisa | Nenhum | Nenhuma | Lista grande e fixa |
| Busca no seu sistema | O seu sistema devolve quando o modelo pede | Busca, ordem e filtro | Uma por busca | Ferramentas por cliente ou por permissão |
A busca no seu sistema serve quando cada cliente usa ferramentas diferentes. Quem precisa de resposta rápida deve preferir a busca feita pelo Google.
Cuidados antes de ligar
Limites da documentação:
- Só funciona na Interactions API, a API nova de conversa do Gemini. O método antigo (generateContent) não aceita.
- Está em teste e exige a versão v1beta da API. O formato pode mudar até a versão final.
- A ferramenta carregada fica na conversa até o fim; não dá para tirar.
- As ferramentas não ficam guardadas entre um pedido e outro: a lista completa tem de ir sempre.
- Quem guarda a conversa no próprio sistema precisa devolver os passos da busca sem mudar nada, senão o pedido seguinte dá erro.
- Busca que não acha nada vira resposta em texto, não um erro.
- Ferramenta citada pelo nome nas instruções do atendente ou na resposta de outra ferramenta deve ficar sempre carregada. Se for adiada, o pedido dá erro 400 e a conversa não continua.
Há uma diferença entre as fontes. O anúncio diz que a busca funciona com o Gemini 3.6 em diante, incluindo todos os Gemini 4. A lista da documentação, lida em 19/11, traz só o Gemini 4 Hydrogen, o Gemini 4 Argon, o 3.8 Flash e o 3.6 Flash. Antes de ligar no Gemini 4 Neon ou no Carbon, faça um teste: modelo sem suporte devolve erro 400.
Para a maioria dos atendimentos, o modelo indicado continua sendo o barato; veja o preço do Gemini 4 Hydrogen. Separar as ferramentas mais usadas das raras faz parte do atendimento automático com inteligência artificial que a Transmitter monta.
Perguntas frequentes
A busca de ferramentas do Gemini é paga à parte?
Não. O Google cobra só os tokens de sempre, no preço do modelo usado. Entram na conta um bloco fixo de instruções, cerca de 26 tokens por ferramenta adiada e, em cada busca, uma nova chamada ao modelo que reenvia a conversa inteira, cobrada como entrada.
Vale ligar com poucas ferramentas?
Em geral, não: no exemplo do Google com 10 ferramentas, a entrada sobe 37%. Deixe sempre carregadas as que são usadas em quase todo atendimento.
Funciona com qualquer modelo Gemini?
Não. A documentação lista o Gemini 4 Hydrogen, o Gemini 4 Argon, o 3.8 Flash e o 3.6 Flash. O anúncio fala em todos os Gemini 4, então teste antes no modelo que você usa.
Fontes
Fontes: lidas em 19/11/2026. A conta em dólar é nossa, com o preço da tabela oficial.
- Anúncio da busca de ferramentas (19/11/2026): blog.google
- Documentação da busca de ferramentas, com os exemplos e os limites: aistudio.google.com
- Documentação da chamada de funções (20 a 30 ferramentas): aistudio.google.com
- Tabela de preços da API do Gemini: aistudio.google.com
