
Desde 16/11/2026, os pedidos aos modelos de texto pelo serviço de inferência do Hugging Face passam pelo roteador da OpenRouter, que escolhe a cada chamada o fornecedor com a melhor mistura de preço, velocidade e estabilidade e, se um falhar, tenta outro na mesma chamada. O código de quem já usa não muda e o preço também não: paga-se o preço do fornecedor, sem acréscimo do Hugging Face. Para a empresa brasileira, é um caminho mais simples para usar modelos de pesos abertos, que custam em média cerca de um quarto dos fechados, num robô de atendimento ou de documentos.
Atualizado em 18/11/2026. Conferido no anúncio do Hugging Face de 16/11/2026 e em duas publicações da OpenRouter (28/10 e outubro de 2026), lidos na mesma data.
Neste artigo
- O que foi anunciado
- O que muda em relação a antes
- Modelo aberto × fechado em números
- Como a empresa brasileira pode usar
- Perguntas frequentes
- Fontes
O que foi anunciado
O Hugging Face é o site onde os laboratórios publicam os modelos de pesos abertos, aqueles que qualquer um pode baixar e rodar. A OpenRouter é uma central que repassa cada pedido a um dos mais de 80 fornecedores que rodam esses modelos. No anúncio de 16/11/2026, o Hugging Face disse que trocou o roteador próprio do seu serviço de inferência pelo da OpenRouter. Com o mesmo token do Hugging Face, todo modelo aberto do site que algum fornecedor serve pode ser chamado pela mesma interface, que aceita o formato de pedido da OpenAI e o da Anthropic (Hugging Face, 16/11/2026).
Imagem, vídeo e áudio continuam como antes, sem passar pela OpenRouter. O próximo passo anunciado é ligar a conta da OpenRouter à do Hugging Face.
O que muda em relação a antes
Antes, o serviço escolhia um fornecedor para o pedido e devolvia o erro dele se falhasse. Agora o pedido é refeito em outro fornecedor dentro da mesma chamada. A conversa também fica no fornecedor que guardou o cache dela, para aproveitar o que já foi lido. Quem quiser pode fixar a regra no nome do modelo: o padrão é o melhor equilíbrio; “:fastest” pede o mais rápido; “:cheapest”, o mais barato; e o nome de um fornecedor prende o pedido a ele.
A OpenRouter mediu o novo roteamento antes da parceria: 46% menos erros por falta de capacidade, primeira resposta 16,9% mais rápida e 16,3% mais volume por segundo, com custo 6,0% maior (OpenRouter, 28/10/2026). Há uma mudança que quebra quem já usava: com os modelos de texto, não dá mais para usar a chave própria de um fornecedor; tudo é cobrado na conta do Hugging Face.
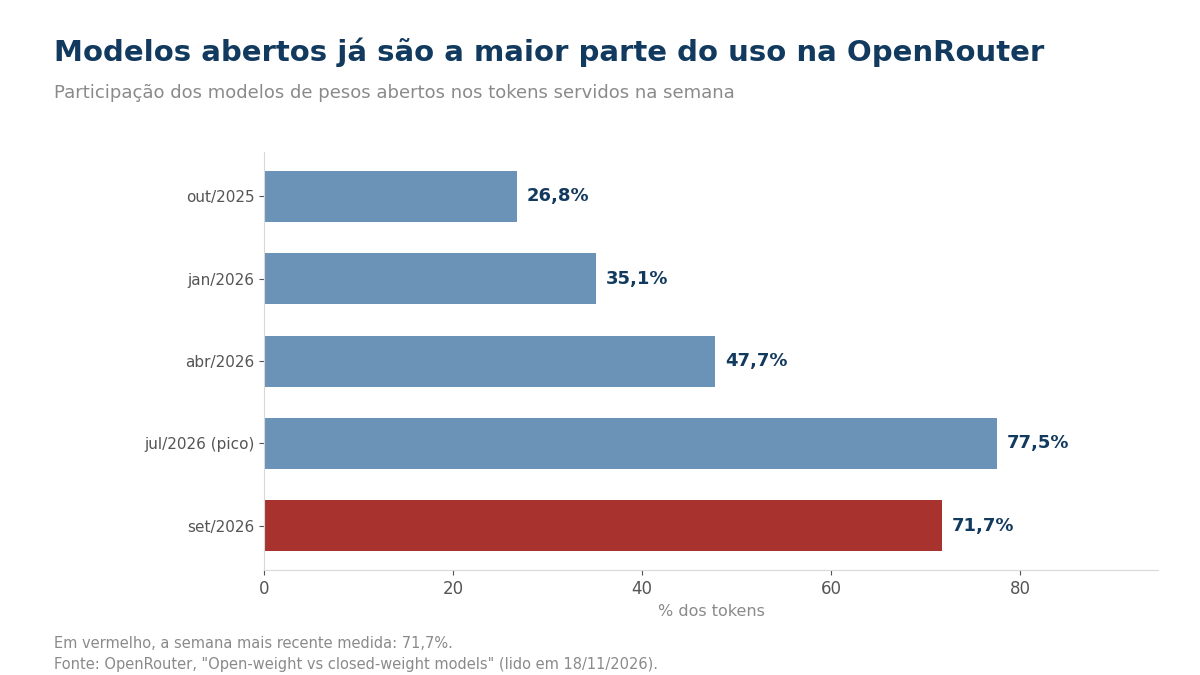
O pano de fundo é o uso dos modelos abertos, que saíram de 26,8% dos tokens servidos pela OpenRouter em outubro de 2025 para 71,7% no fim de setembro de 2026, depois de um pico de 77,5% em julho.
Modelo aberto × fechado em números
| Ponto | Pesos abertos | Pesos fechados |
|---|---|---|
| Preço médio por milhão de tokens (entrada / saída) | US$ 0,28 / US$ 1,62 | US$ 1,27 / US$ 6,36 |
| Quem serve | Qualquer fornecedor; 20 a 31 nos modelos mais usados | O fabricante e poucas nuvens licenciadas |
| Melhor nota no índice da Artificial Analysis (citado pelo Hugging Face) | Kimi K3.1 Pro: 46 | Claude Fable 5.2: 65 |
| Custo por tarefa no mesmo índice | US$ 3,68 | US$ 26,54 |
As notas da tabela são as do anúncio do Hugging Face (16/11). Na tabela da OpenRouter de 31/10, antes dos lançamentos seguintes, o melhor aberto tinha 46,3 (MiMo-V2.6-Pro) e o melhor fechado 57,6 (Claude Opus 5.5).
A conta mostra a troca: o melhor modelo aberto fica atrás nas provas mais difíceis, mas custa cerca de um sétimo por tarefa. Os preços médios são da OpenRouter (últimas 4 semanas, ponderados pelo uso) e foram repetidos no anúncio do Hugging Face.
Como a empresa brasileira pode usar
Para atendimento do dia a dia (segunda via, horário, andamento de pedido), um modelo aberto costuma bastar, e a diferença de preço pesa quando são milhares de conversas por mês. Tarefa difícil, como ler contrato longo, ainda pede modelo fechado. Para comparar, o que a OpenAI cobra pelos seus modelos está em GPT-6.2 Sol e Astra: preço e qual usar, e o do Google em Gemini 4 Hydrogen.
Dois cuidados. Os dados da conversa vão ao fornecedor que atender, e a LGPD continua valendo: nas configurações dá para desligar o fornecedor que a empresa não quiser. E a cobrança é em dólar, na conta do Hugging Face. É esse tipo de escolha (qual modelo, onde roda, quanto custa) que fazemos ao montar o atendimento automático com inteligência artificial no WhatsApp e no site.
Perguntas frequentes
Ficou mais caro usar o Hugging Face?
Não, segundo o anúncio: o preço é o do fornecedor, sem acréscimo do Hugging Face. A OpenRouter mediu custo 6,0% maior no novo roteamento porque ele nem sempre escolhe o mais barato; quem quiser o menor preço pode pedir “:cheapest”.
Preciso mudar o meu código?
Não, se você usava o serviço de inferência do Hugging Face com o token dele. Muda para quem usava a chave própria de um fornecedor nos modelos de texto: isso deixou de funcionar.
Modelo aberto serve para atendimento ao cliente?
Para pergunta que se repete, em geral sim, e por um preço médio cerca de quatro vezes menor. Para tarefa que exige raciocínio longo, os fechados ainda tiram nota maior.
Fontes
Fontes:
- Hugging Face, 16/11/2026, “Hugging Face and OpenRouter join forces to make open-weight models easy to run”: huggingface.co
- OpenRouter, 28/10/2026, “How we rebuilt provider routing for better, faster inference”: openrouter.ai
- OpenRouter, outubro de 2026, “Open-weight vs closed-weight models” (participação semanal e preços médios): openrouter.ai
- Artificial Analysis, índice de inteligência dos modelos, citado pelo Hugging Face no anúncio (citado pelo nome)
